简介
DQKV 是一个面向大模型推理效率的科研项目。它给 Transformer 每层额外加一组很小的投影 D_Q/D_K,让模型在真正算注意力之前就给每个 token 打出“删除分数”,判断它还有没有用;没用的 token 被提前裁掉,KV cache 占用和预填充阶段的无效计算都会下降。项目以 Qwen 34B 为底座,低删除率下质量已追平不训练即可压缩的强基线 H2O,适合关注 KV cache 压缩与高效推理的研究者。
项目缘起
Transformer 推理有两个老问题:KV cache 随序列长度线性增长、显存越来越贵;注意力计算随长度二次增长、越来越慢。还有一个常被忽略的浪费——预填充阶段输入 N 个 token,每层都输出 N 个 token,但只有最后一个输出真正有用(它是自回归生成的起点),前面 N−1 个位置的输出全是白算。我们想:与其让 token 一路“矩形”地穿过所有层,不如让模型逐层裁掉已经没用的 token,把它变成“锥形”,同时省下 KV cache 和预填充开销。直觉是 token 在层间传播时语义会交融,有些 token 的信息会被别人吸收、有些彻底没用。由此设计了独立的删除信号 D_Q/D_K。过程中遇到关键转折:删除本质不可导、极难训练;训练数据从维基换成推理数据集后质量才稳住,但也暴露出“删多了质量掉、早期信息被系统性丢弃、删除扎堆单层”三个核心问题,目前仍在解决。
项目概览
它怎么做
-
加删除投影:每层新增小投影 D_Q/D_K,在 attention 前算出删除分数,判断 token 还有没有用;
-
软训练、硬推理:训练用带温度的软掩码逐步降温,推理时真删 token 并同步裁掉 KV cache;
-
删除与注意力解耦:删除信号单独学,不依赖 attention 权重,表达能力更强;
-
对照 H2O:H2O 不训练、按注意力保留约 20% token,DQKV 低删除率下已追平其质量;
-
融合 DeepSeek 稀疏注意力:同源架构,小投影先筛再算完整 attention,兼顾算力与信息保护。
项目亮点
-
在 attention 之前就能“知道该删谁”:只用很小的投影提前完成筛选,省掉的是真正昂贵的注意力计算——这是 H2O 这类“先算完再看”的方法做不到的。
-
删除与注意力解耦
注意力反映“token 之间谁在看谁”,不等于“token 有没有用”;单独学的删除信号,让模型既会看、也会判断该留谁。
-
软删除到硬删除的渐进训练
删除本质上不可导,项目用温度退火的软掩码让它变得可训练,推理时无缝变成真正的物理删除,实测最高约 2.4 倍提速。
-
低删除率下追平强基线 H2O
H2O 无需训练、保留约 20% token;DQKV 在下游 4 任务宏平均上以 0.6683 追平 H2O 的 0.6699(Vanilla 基线 0.6726)。
-
敢于暴露并拆解核心问题
明确诊断出“质量-删除权衡、早期信息系统性丢失、删除扎堆单层”三大难题,并给出与 DeepSeek NSA 融合、层间平衡正则等可落地的改进路线。
技术与方法
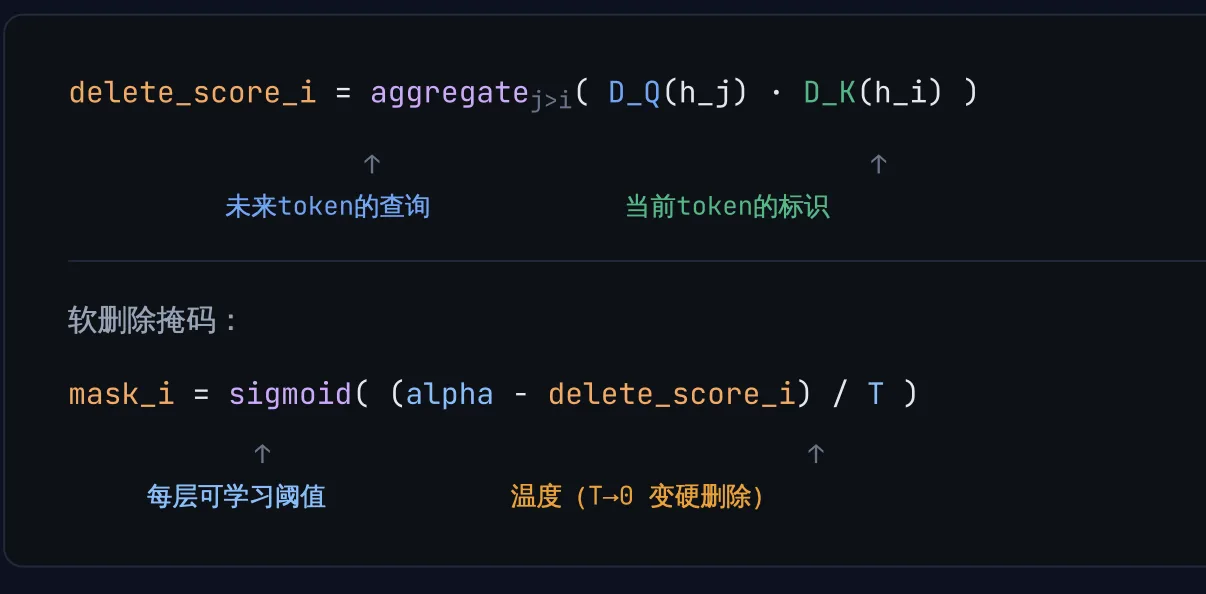
核心是给 Transformer 每层额外加一对很小的投影 D_Q/D_K,在真实注意力之前计算删除分数:delete_score_i = aggregate_{j>i} D_Q(h_j)·D_K(h_i),即用未来 token 的 D_Q 点积当前 token 的 D_K,分数越高代表该 token 越可能已被后面吸收、可以被删。与 attention 不同,这里不做 softmax——归一化会引入“注意力汇”式的强制分配,且删除后无法恢复。
训练用软删除掩码 mask_i = sigmoid((alpha − delete_score_i)/T):alpha 为每层可学习阈值,T 为随训练退火的温度(T→0 收敛为硬删除);删除率计入 loss 强迫学习,并逐步提高目标删除率。因被删 token 无法反传,训练用 2L token 序列,只在前 L 个 token 上删除、用后 L 个算 loss。底座为 Qwen 34B(32 头 × 128 维注意力),D_Q/D_K 仅单头 256 维,使用与基座一致的 RoPE 位置编码。推理时真正物理删除:token 在第 K 层被删后,前 K−1 层 KV cache 保留、从 K 层起消失。
对照 H2O(不训练、按真实注意力保留重要 + 最近约 20% token),低删除率下 4 任务 macro accuracy 0.6683 ≈ H2O 0.6699(Vanilla 0.6726)。当前瓶颈:删除信号仍难训练(删到 30% 质量明显下降,或需完整预训练)、训推不一致(软/硬删除、2L 窗口)、早期 token 被系统性误删(NIAH 前 25% 位置几乎全错)、删除扎堆到个别层;改进方向含层间平衡正则、从分数/阈值层面加“必保 token”兜底,以及把删除决策建立在 DeepSeek NSA 稀疏注意力架构上。
成果与数据
实验底座:Qwen 34B;评测:Downstream 4 任务 macro accuracy(5-shot)
- Vanilla 基线:Macro 0.6726,实际删除0;不删除基线
- H2O(20% 保留):Macro 0.6699,实际删除约 80%;不训练强基线
- DQKV(低删除):Macro 0.6683,实际删除低;追平 H2O,质量几乎无损
- DQKV conservative:Macro 0.6694,学到阈值 X 均值 2.86,实际删除几乎不删;X 卡在初始值 3.0,“质量好”是假象
- DQKV phase1:Macro 0.6536,学到阈值 X 均值 2.87,实际删除中;中等删除开始掉点
- DQKV highdel phase2:Macro 0.6192,学到阈值 X 均值 2.09,实际删除高(−5.3 点);阈值真训下来、真删后质量下降
- 可无损删约 10%:各类基准分数基本不变;删到 30% 掉约 5.3 点,说明删除信号仍不够好
- 物理删除提速最高 2.39×:真实删除带来推理加速,删 30% 时自回归阶段约提速 2 倍
- NIAH(highdel):整体 0.45 vs Vanilla/H2O 0.98;针在前 25% 位置几乎全错、后 25% 全对——早期信息被系统性误删
未来方向
- DQKV × DeepSeek 稀疏注意力融合:把删除决策建立在已被工业验证的“闪电索引器”式小投影架构上——小投影先做删除决策,保留 token 再算完整 attention,同时解决计算优势与早期信息丢失;
- 从分数/阈值层面根治早期信息丢失:为早期与关键 token 增加“必保”兜底机制(对标 H2O 的硬性 recent buffer);
- 层间平衡正则:约束各层删除率不要悬殊、惩罚单层垄断,把“每层独立判断”的潜力真正用起来;
- 改进删除信号的训练:考虑以完整预训练获得更好的删除信号,并缓解训推不一致——随机化 2L 训练窗口、在更长序列上评测、分析 RoPE 近端偏好带来的偏差;
- 更大规模与真实场景验证:当前训练数据约 4K、偏短,计划扩展数据集并接入真实长程 agent 任务做端到端测评。