简介
mathminer数学挖矿项目,是一套完全自动化将自然语言证明形式化为lean代码的harness框架,最终愿景是可以高效的将人类海量的自然语言证明转化为形式化的证明,投入token,产出proof,我称之为数学挖矿⛏️
项目缘起
一年以来,当前LLM的数学能力和代码能力有了跃进级别的提升,这使得全自动的把数学证明形式化为lean代码的工作成为可能
我过去一年也进行了大量的数学形式化证明的实践,erdos#224的形式化以及Sylvester-Schur的形式化,我也都投入了许多人力介入,来推进LLM的证明
最朴素的思路是,直接把论文和命题交给codex,设置goal为彻底无sorry、admit和axiom的lean证明,然后让它自己以论文为纲领一点一点把证明写出,erdos#732就是这么解决的,但是这个方法对于复杂的数学定理,可能还有大量未形式化的数学表示与证明依赖,就会陷入长时间消耗了大量token,但是没有有效推进的情况
在6月份时我尝试了使用multiagent的思路,给模型分配ABC三个role,分别聚焦项目协调与宏观lemma设计,中层的证明拆分,以及最底层的lean代码编写(填一个足够小的sorry),但是这个架构并没有看到优势,它大量的token消耗聚焦在了lean代码相关事项上,对于数学理解与决策,显得极为草率,甚至写出的代码蕴含的数学理解停留在定理的边角料水平
技术与方法
上面最核心的问题是数学理解、接口设计、代码生成,三大内容是强耦合的,这会导致 1.模型同时在想lean代码和数学内容,造成不必要的token浪费 2.因为所有的数学思考在上下文中,模型的上下文不足以支撑海量的lean以及数学细节 3.不同时刻写出的接口和证明可能存在冗余与难以对齐,甚至偏离数学路线,产生无效返工 但它们本身就不需要耦合,我在时间上和空间上对其进行解耦,不设置复杂的multiagent的role,而是在时间上进行分层,分为不同的stage,流水线运转,每一个stage完成后才进行下一个stage,但是stage发现了前面stage的defect可以跳回前面去补救
数学理解
首先,数学证明形式化最核心的是充分利用好人类的自然语言证明,因而最初的stage0,就是在网络上查找下载完成证明所需的全部数学论文,并进行初步低成本的记录和ocr 在stage1,对论文进行清洗,多agent并行流式阅读论文,每次阅读论文中的一块,然后对其内容进行阅读理解,把其前提、结论、证明推导逻辑提取出来,对每一块进行定性(和形式化定理是否有关、是否有帮助、是否是证明主干),然后给出相应的理解、容易出错的地方( quantifier,渐进性质的依赖变量等)给出批注,有自然语言逻辑上的跳步、以及形式化上的可能的gap,都标明并列出工单,而且对于这一部分数学的难度要给出定量的评估,来决定后面消化这一部分的处理深度,边阅读边输出,输出结束后agent retire,开全新agent,让agent能在黄金上下文精准的干困难的工作 在stage2,专注去看stage1的工单,这个数学上的gap,是否可以通过简单的推理补齐,现有的论文的数学内容能否补齐这个gap,在reference和互联网上搜索它所表述的数学命题是否有别的文献得以证明(回到stage0进行下载),把数学上gap彻底消除,得到一个完整的数学证明覆盖图(图上的前节点是一个个stage1、2的blocks),在这个时候要重新理解每一部分证明的难度和处理深度
接口设计
在stage3,则是去大批量扫互联网的几大github仓库,找是否有和证明相关的lean形式化可复用的内容 然后在所有数学去看证明是否 1.已经被完全覆盖了(考虑采用证明)2.有相似的命题(参考思路进行复用)3.已下载的内容没有相应的证明(去专门搜索相应的仓库) 在stage4,有了这些可复用的证明、证明思路、与可能冲突的接口设计,现在要做的就是以最优的方式做lean定义的接口设计,核心理念,尽可能不从头造轮子,使用较好封装的接口,使用可复用形式化证明众数的接口,把所有定义的lean代码都写好,流式阅读stage1、stage2的产出,把所有所需lemma都按照定义写对,证明项全不填写sorry掉,但是要保证证明是可以填上的(lemma没有出错)、没有多余的封装lemma、前提是足够的且不是过度的 在stage5,则是评估出哪些是真正的证明节点,这些草率产生的数学前节点是否仍需要拆分和合并以及丢弃,从stage2的证明覆盖图中诞生出由定义、lemma、上游接口、下游接口、已有的可参考或完全覆盖证明、论文中的数学路线和完整无gap的证明流程构成的一个个真正的证明节点,在这个时候要对每一个证明节点的数学复杂性、数学完整性(数学细节程度)、实现困难度、预估代码行数,进行评估,让每个节点的实现困难度维持为一个定值,因而可以拆分前节点和合并前节点(比如如果一部分数学证明几乎都被前人lean cover掉了,那所需做的就是修修细节把接口对齐,把管道打通,可以一堆节点放在一块),对每一个节点要完整真实的放在一个文件夹中,而且是自包含的且不耦合的,后续代码worker只需要阅读这个文件夹内部的内容就足以完成证明,
代码生成
在stage7(编号是历史遗留问题)则是真正开始写lean代码,就是用orchestrator并行的拉起若干的worker,worker每次只处理一个节点,节点完成后,orchestrator把它的上下文压缩掉,然后委派新的任务(最好是有相关性的任务),worker的处理逻辑是分为 phaseA 通过提取精华的lean4skill、lean-lsp 理解数学证明脉络与思路,要做到彻底明白应该怎么写代码,能够保证自己能一次写对的情况下,进入phaseB,一次性bulk write一个500行左右的证明文件,进入phaseC,我设计了一个结合了lean-lsp 等工具的tool,使得它可以一次性返回所有的证明上的疏漏和错误,可以让agent一次性改很多地方,提高效率,如果发现证明的问题不是小修小补可以解决的,回退到phaseA,重新分析数学,尽可能少的使用lake
这个500行左右是一个超参数,block_scale,取决于我能够把前面的几个stage给出的数学指引做到多细,也取决于大模型的代码能力,事实上LLM具有高质量的长代码输出能力就应该bulk write的输出lean,而不是像人一样交互式写lean
最后一个stage8,把证明好的材料进行整理编译,并通过comparator的检验,达到可以发布的验证级别
因为写lean是一件很困难很摩擦的事情,如果直接让它写lean就会导致之前的问题,前面的步骤其实主要在数学本身的范畴所以会比较高效,最优化token消耗的核心在于如何让数学理解和接口设计尽可能的慢(深入的思考,产出的质量更高)而lean coding的尽可能的快(不要返工,各种修细节耗时)
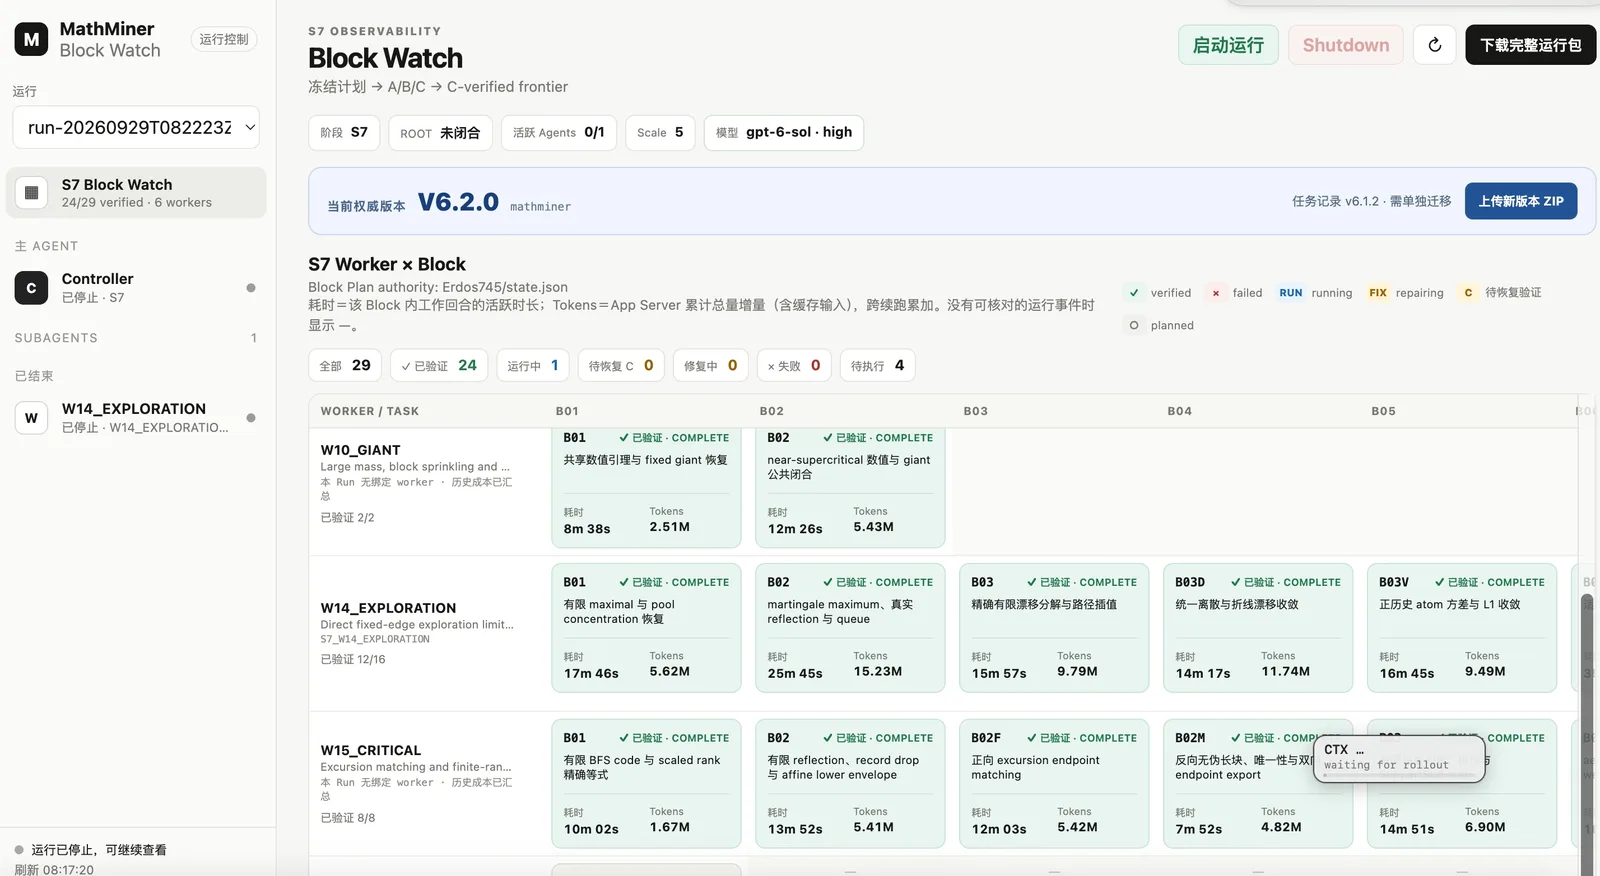
这就给了我们一个很好的profiling optimization空间,于是我开发了mathminer ops,可以在服务器上观察stage7每一个block的运行的情况,许多可观测指标,如token消耗,ABC token占比,耗时,tool calling次数,包括每个block在推进还是失败 我们还可以通过这个来做许多实验,测试不同模型,在不同上游供给、不同设计下的lean coding效率,来进行专项的独立的控制变量的调优,不断精进框架设计 后续我会把stage0-5也纳入ops中,方便进行优化设计
实验与成果
我在开发框架的过程中,形式化了 erdos#448 和 erdos#745,两个在朴素harness下,耗时多天,耗费大量token仍然无法解决的复杂难以形式化的erdos问题
下一步我的目标是Calabi-Yau定理,使用框架解决一个最前沿的大名鼎鼎的closed theorem