简介
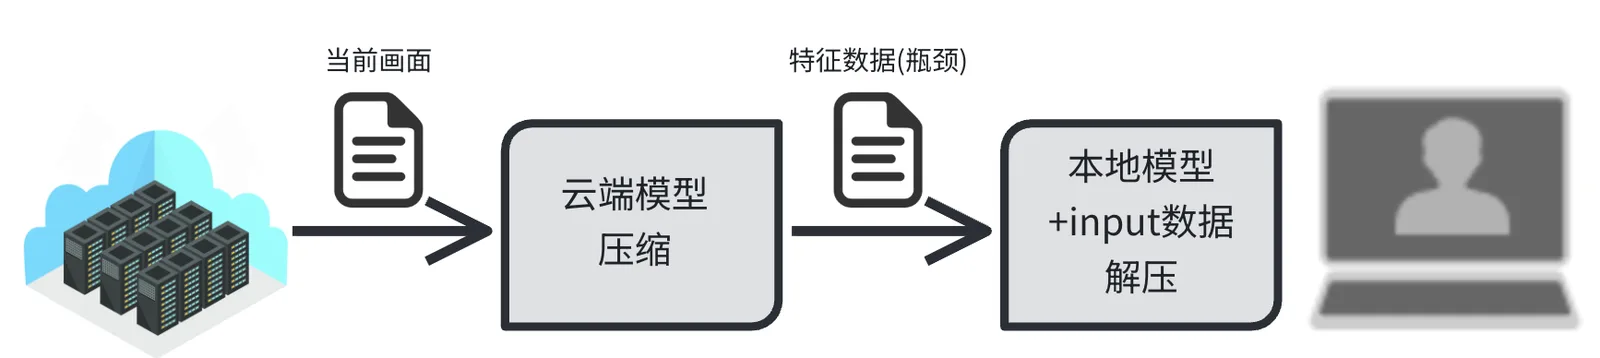
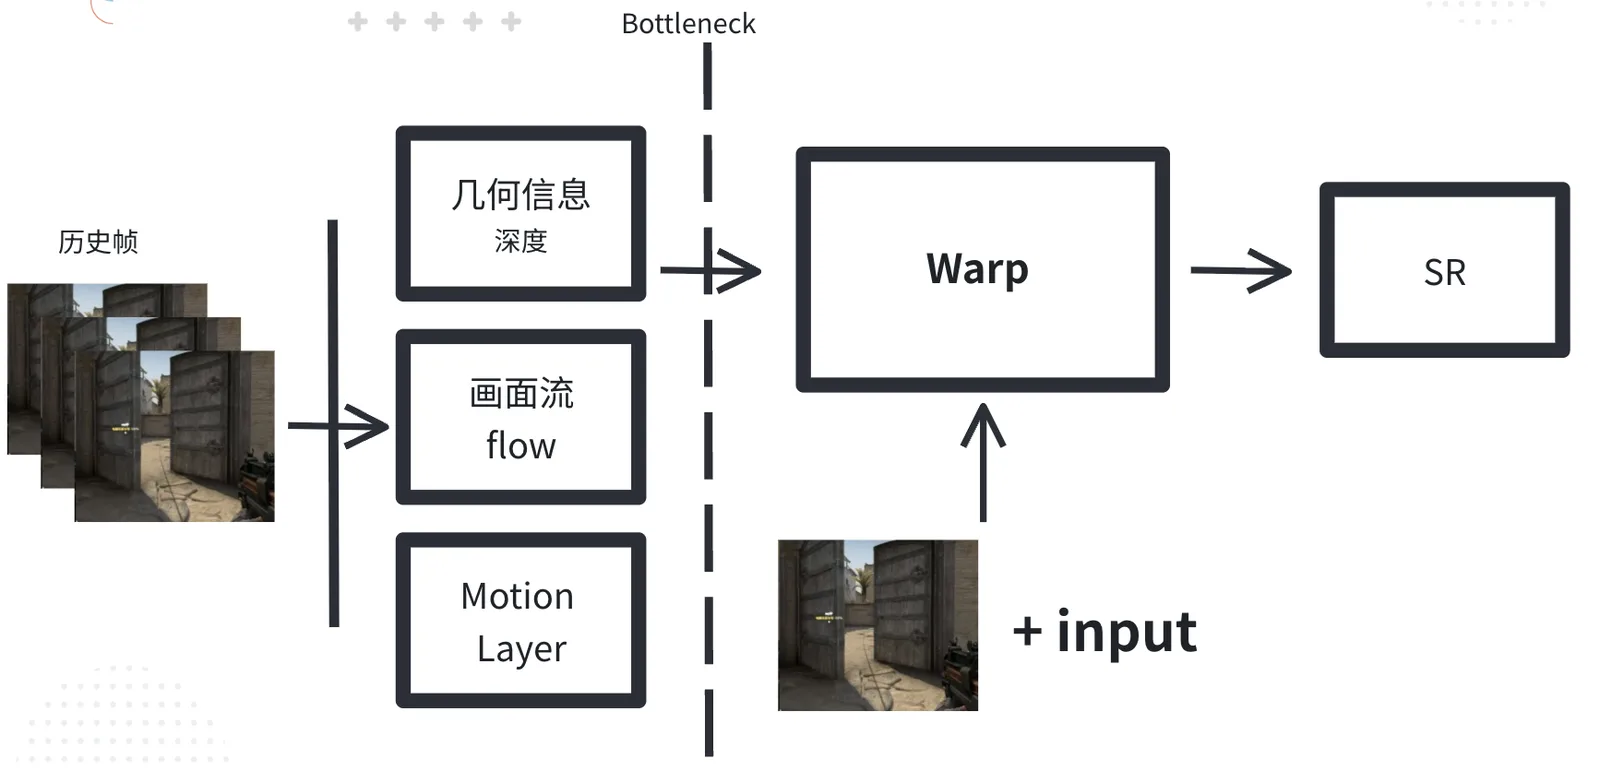
Pred1ct0r 是面向云游戏的低延迟帧预测系统。针对 FPS/TPS 云游戏中操作反馈延迟导致难以跟枪的痛点,重计算放在云端:提取深度、光流与运动分层(HUD、角色、场景)等视觉特征,经瓶颈压缩后下发;端侧轻量模型结合玩家鼠标与按键输入,通过反向 Warp 从上一帧采样重建下一帧,在不增加等待的前提下"预演"操作结果。
项目缘起
云游戏把渲染搬到云端,让玩家无需高配硬件即可玩大作,但延迟始终是 FPS/TPS 品类的硬伤——玩家移动鼠标后,往往要等两倍延迟才能看到画面跟上,跟枪体验几乎不可用。传统网络优化只能压缩几十毫秒,无法根本解决。AI 生成模型的发展带来新思路:高帧率下相邻两帧差异很小,能不能让模型在玩家操作的同时"提前算出"操作后本该出现的那帧?项目由此出发,从最朴素的光流 Warp 起步,逐步引入云端特征提取、Teacher 模型蒸馏与输入条件融合,试图在端侧算力预算内做出可用的延迟掩盖方案。
项目概览
它怎么做
-
云端重算:服务端从当前帧提取深度、光流和运动分层(HUD/角色/场景),经瓶颈压缩后下发;
-
本地补全:端侧小模型结合鼠标与按键输入,通过反向 Warp 从历史帧采样重建下一帧,参数量小、可实时运行;
-
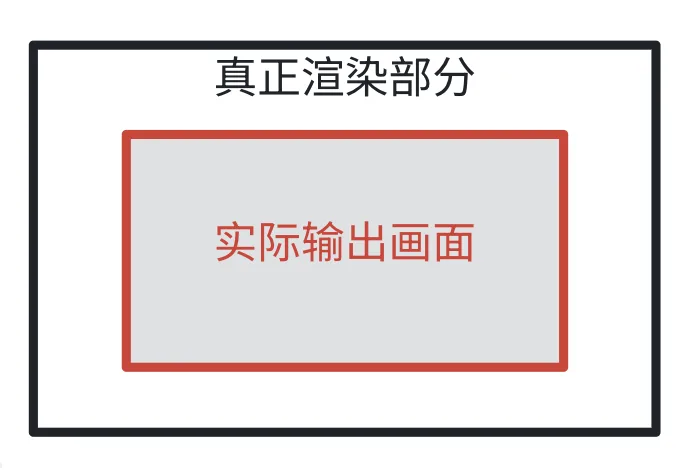
输出收缩:实际渲染区比显示区大一圈,HUD 收进中央安全区,镜头转动时边缘不再出现残影和空洞;
-
输入感知:用 Cross-Attention + FiLM 把操作信号作为强条件注入,并用 Shuffle-Input 损失强迫模型区分正确与错误输入。
项目亮点
-
云端特征/端侧推理的分工
重的深度、光流提取放在云端大模型,端侧只跑轻量 Warp,在带宽与算力之间取得平衡。
-
Teacher 模型蒸馏视觉先验
借助 Depth Anything、RAFT、SAM3 等成熟模型生成深度、光流与运动分层的监督信号,小模型不必从零学起。
-
输入条件显式注入
Cross-Attention + FiLM 让鼠标移动、按键成为影响输出的强因素;Shuffle-Input 对比损失在不增加数据的前提下教会模型"听操作"。
-
反向 Warp 消除空洞
逐像素追溯采样来源,而非前向搬运,配合顺序采样避免多像素撞车造成黑块。
-
输出安全区设计
HUD 浓缩到画面中央、渲染区大于显示区,镜头旋转时边缘不再撕裂或露出背景。
-
面向实时的轻量化验证
本地模型只完成 Warp 即可实时运行,云端已跑通 60 FPS,验证了技术路线可行性。
技术与方法
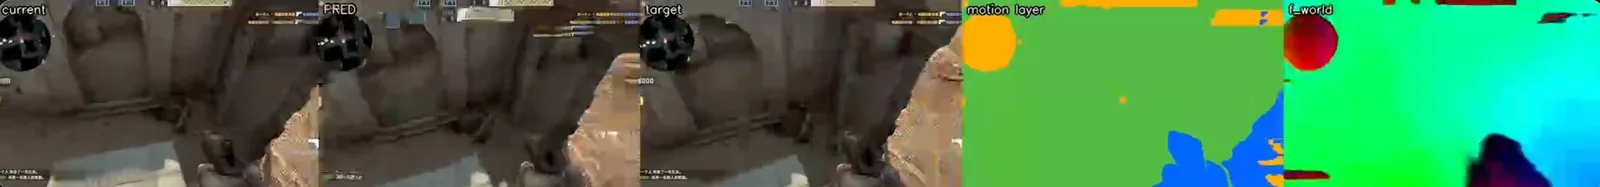
系统采用云端-端侧两阶段架构。云端对当前帧提取三类中间表征:用 Depth Anything V2(冻结)输出深度图,用 RAFT 估计历史帧间光流,并用 SAM3 生成分割掩码再以深度边界修正得到运动分层;这些特征经瓶颈压缩后下发。端侧以 U-Net 为骨架,通过 Cross-Attention 融合画面特征与玩家输入(鼠标位移、按键),再经 FiLM 仿射变换让输入信号主导特征通道;输出每个像素的位移场,执行 Backward Warp 从上一帧采样重建,并按静态/动态区域做 Routing 混合。训练时引入 Shuffle-Input 对比损失:对同一帧同时喂入正确输入与打乱输入,约束正确输入的重建误差比错误输入至少低一个 margin,避免模型忽略操作信号。输出层将显示画面收缩到中央安全区,缓解旋转镜头时的边缘遮挡与残影。
成果与数据
- 端到端已跑通:云端特征提取+瓶颈压缩可实时跑到 60 FPS,端侧 Warp 模型参数量小、可在客户端实时运行。
- 验证设置:当前在固定 30 ms 延迟、60 FPS 下快速迭代;输入分辨率 512×288(HUD 收缩后实际可用区域更小);训练素材约 22 分钟。
- 旧架构瓶颈:纯 Warp + Protect Mask 方案用 4 节点、56 GB GPU 训练一整晚,训练集效果仍卡在"略优于照搬上一帧"的 checkpoint,判定为模型容量与输入条件不足。
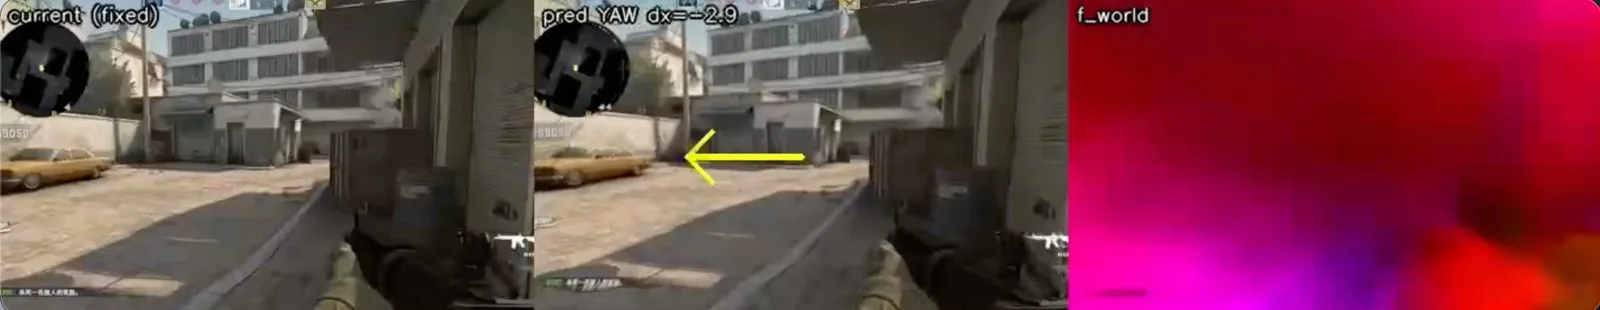
- 视觉质量迭代:纯 Warp(快速抖动时 HUD 抽动)→ +Mask 时序正则 + 输出收缩(边缘残影消除、mask 帧间稳定)→ 新架构(Motion Layer 可清晰区分人物、HUD、场景层次,糊边问题经深度与分层合并修复)。
- Teacher 模型蒸馏:深度用 Depth Anything、光流用 RAFT、运动分割用 SAM3,均冻结作监督信号。
- 输入条件感知:通过 Cross-Attention + FiLM 注入操作信号,Shuffle-Input 对比损失使模型对夸张输入也能做出合理响应。
未来方向
说实话,最终呈现的效果其实一般,远远没有达到我们期望的效果
所以我们正在尝试使用全新的架构去重写整个过程
我们阅读并测试了如下几篇相当有启发性的论文
Neural Supersampling for Real-time Rendering 2020
Diffusion Models Are Real-Time Game Engines, 2024 / ICLR 2025
Image-to-Image Translation with Conditional Adversarial Networks
最终,我们决定借用现代游戏引擎中的 Motion Vector 的 GBuffer 输出去增强我们的预测结果
整体架构也完全抛弃了原先的U-Net预测 warp的方案,转换为 VAE+Flow Matching,通过MV重映射回该帧位置的方式学习之前方案中,在旋转场景下不能有效预测新出现部分的问题
同时我们注意到,一个单一的,平均的Loss函数并不能解决局部高频信息丢失,画面趋于平均化的问题,所以我们引入SinGAN中的判别器结构去修正局部细节
总的来说会是一个大改动,目前的进度在尝试重构 HLAE 的 Afxhooksource2,尝试注入原先CS2中并不具有的Motion Vector的渲染流程并导出